

摩尔线程技术路线图全面公开!刷新国产GPU推理天花板,新架构能效飙10倍


智东西(公众号:zhidxcom)
作者 | ZeR0
编辑 | 漠影
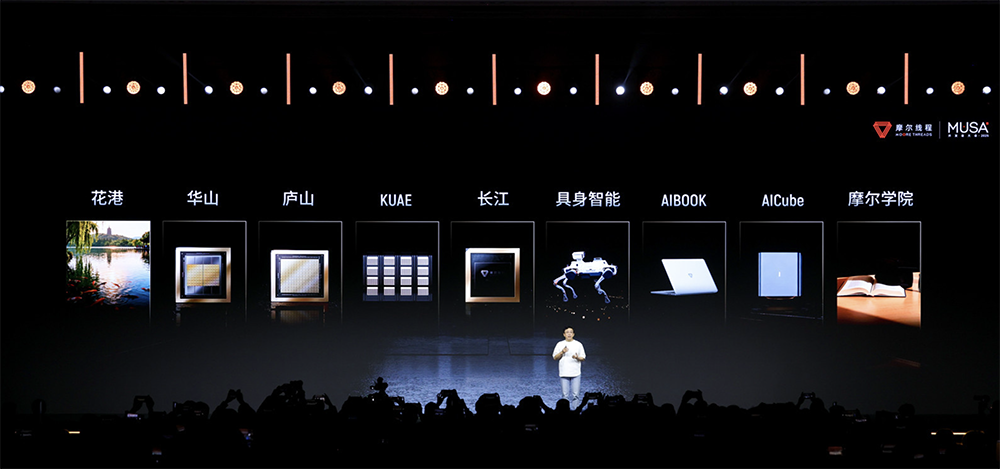
智东西12月20日报道,今日,摩尔线程在首届MUSA开发者大会2025上公布全功能GPU技术路线图,并一连亮出“10张王牌”:新一代全功能GPU架构「花港」、即将发布的AI训推一体芯片「华山」与高性能图形渲染GPU「庐山」、万卡训练集群「夸娥」、刷新单卡推理的「S5000」、智能SoC芯片「长江」、AI算力本MTT AIBOOK、迷你型计算设备AI Cube、具身智能、摩尔学院。
恰逢近期国产GPU声量沸沸扬扬,摩尔线程这场大会,说是万众期待毫不为过。
从交出的年终答卷来看,摩尔线程称得上是诚意拉满。摩尔线程创始人、董事长兼CEO张建中长达2小时的主题演讲,密集披露了覆盖云边端的最新软硬件产品及技术布局。MUSA嘉年华展区琳琅满目的展品与演示,传递出国产GPU生态的勃勃生机。
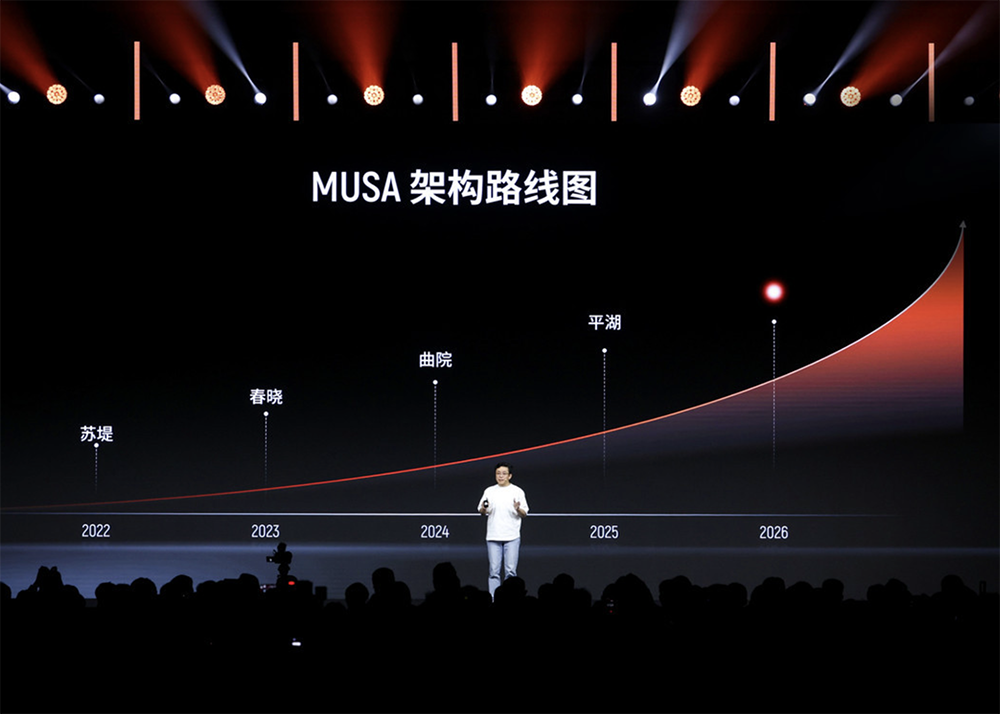
按MUSA架构路线图,其架构每年一迭代,继苏堤、春晓、曲院、平湖后,新一代花港架构终于登场。花港支持FP4到FP64的全精度计算,算力密度提升50%,效能提升10倍,可支撑十万卡以上规模的智算集群。
基于花港架构,摩尔线程即将发布2款芯片技术路线:
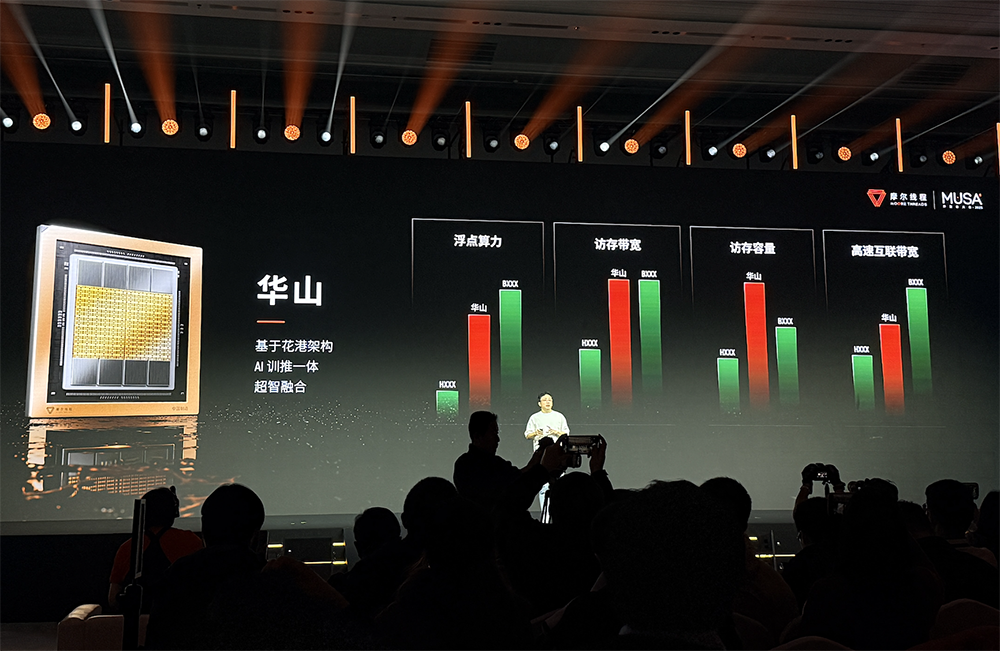
华山芯片专注AI训推一体与超大规模智能计算,集成新一代异步编程与全精度张量计算单元,支持从FP4至FP64的全精度计算,为万卡级智算集群提供稳定高效的算力支撑。其浮点算力、访存带宽、访存容量、高速互连带宽性能均超过业界标杆产品HXXX,部分配置看齐BXXX。
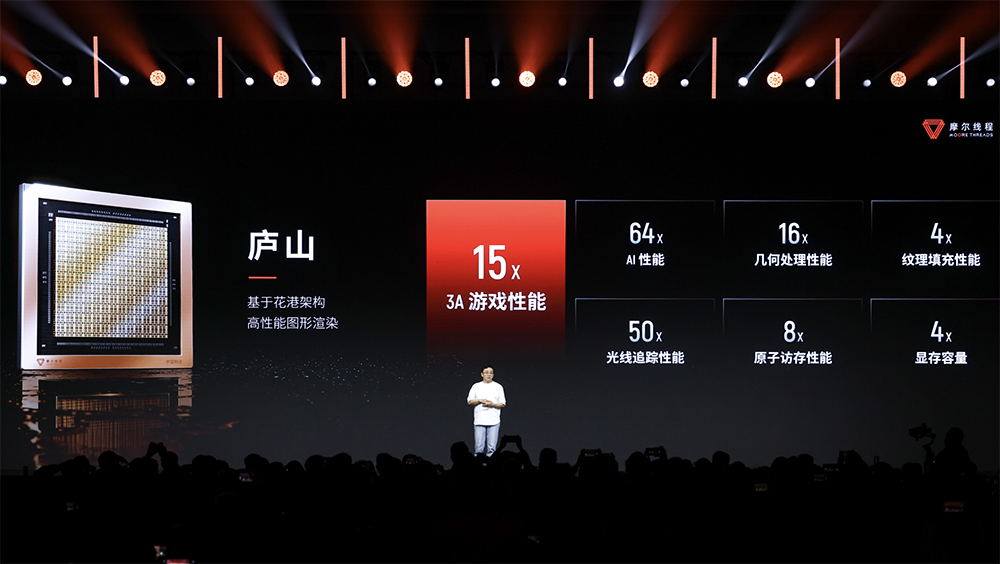
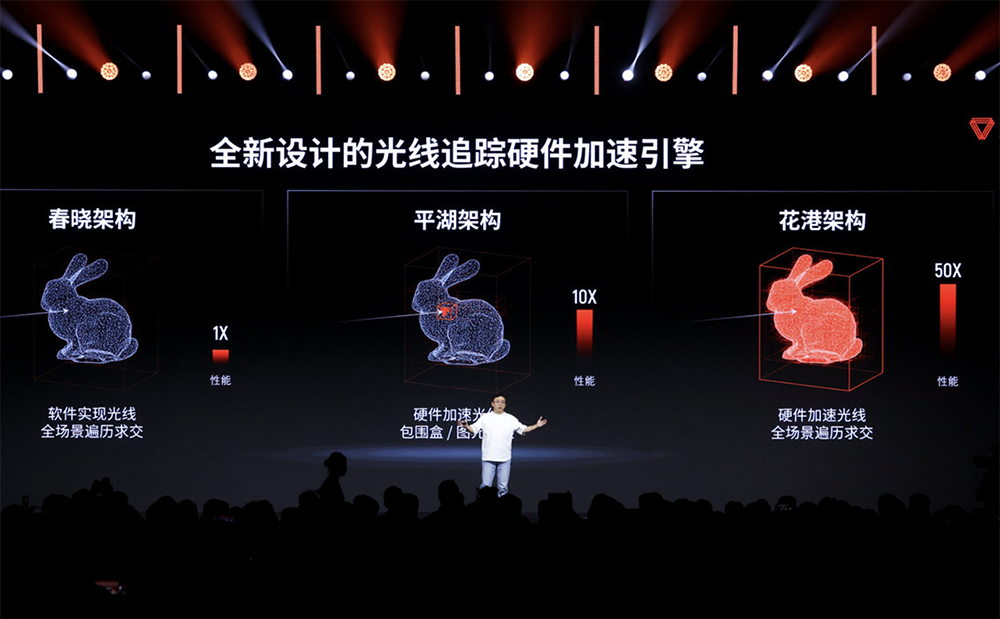
庐山芯片专攻高性能图形渲染,相比MTT S80,3A游戏性能提升至15倍,AI计算性能提升64倍,几何处理性能提升16倍,光线追踪性能提升50倍,显存容量提升4倍,并显著增强纹理填充、原子访存能力;集成AI生成式渲染、UniTE统一渲染架构及全新硬件光追引擎。
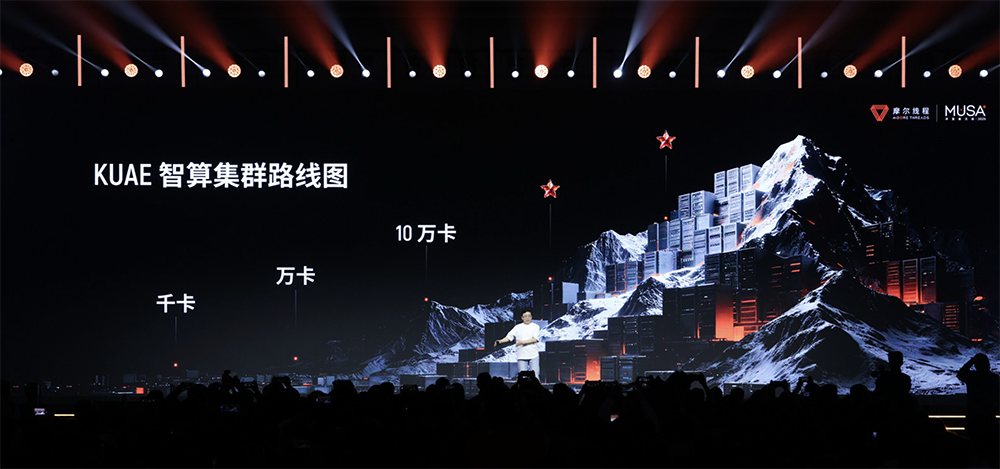
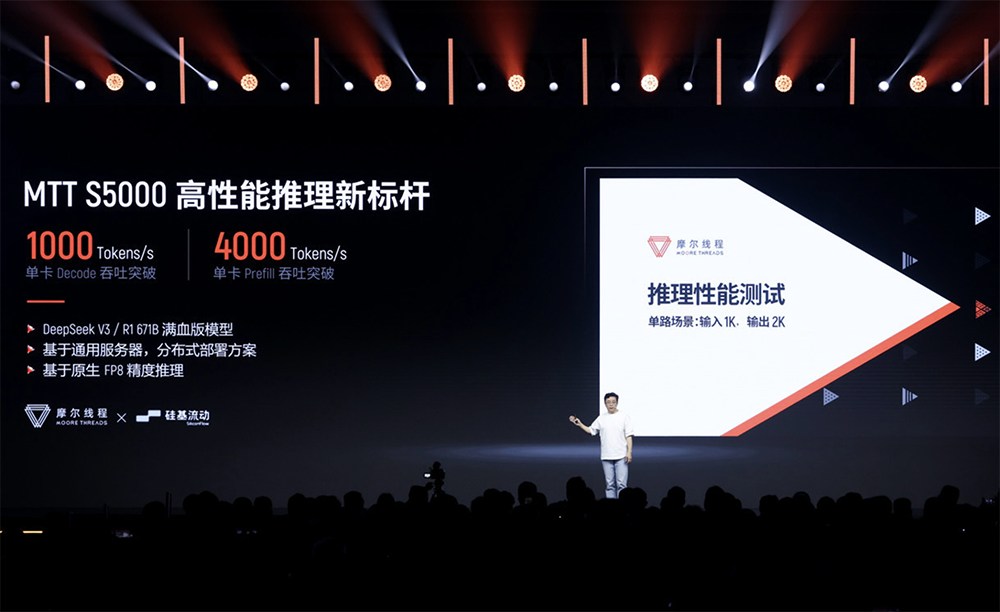
面向云端计算,夸娥万卡智算集群已建成,是真正的用来“训练”的万卡,可支撑万亿参数模型训练;在推理方面,摩尔线程联合硅基流动,大幅提升满血版DeepSeek R1单卡推理吞吐量,S5000单卡Prefill破4000,Decode超千;MTT C256超节点架构专为超大规模智算中心设计,基于高密硬件架构,实现极致智算性能。

张建中说,接下来,摩尔线程将会做10万卡及更大规模的智算集群。
面向端边侧,张建中现场展示了搭载“长江”SoC芯片的第一台AI算力本MTT AIBOOK。
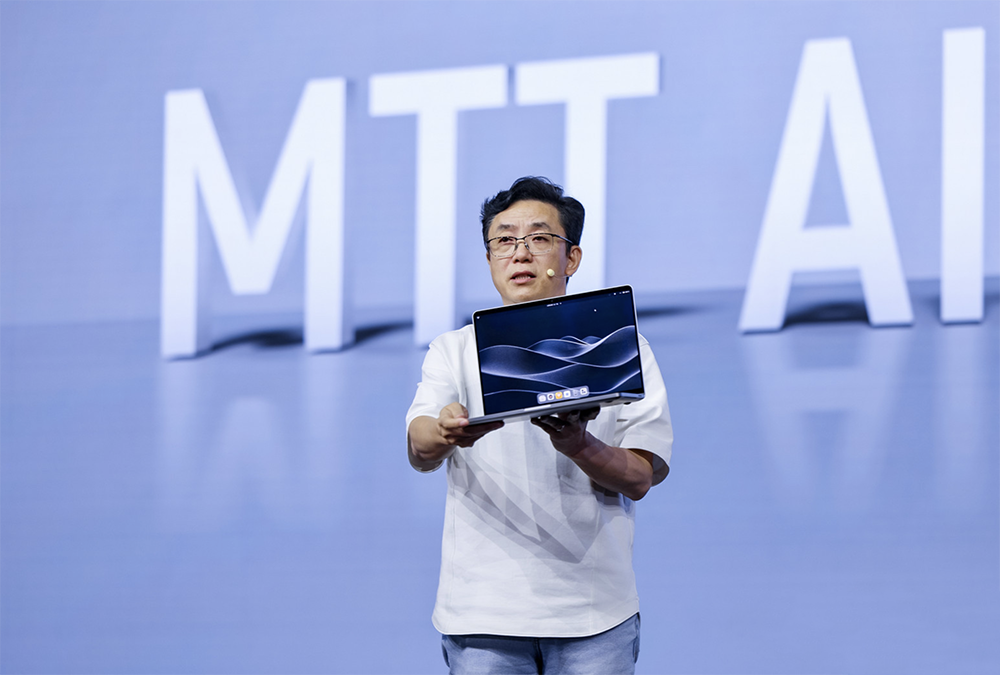
这款AI算力本集开发、办公、娱乐于一体,提供50TOPS异构AI算力,具备多系统兼容能力,预置了AI开发环境与工具链,可在本地运行最高30B的端侧大模型,内置智能体“小麦”及多种AI应用,支持8K超高清视频播放、外接4屏,今日起在京东商城开启预售。
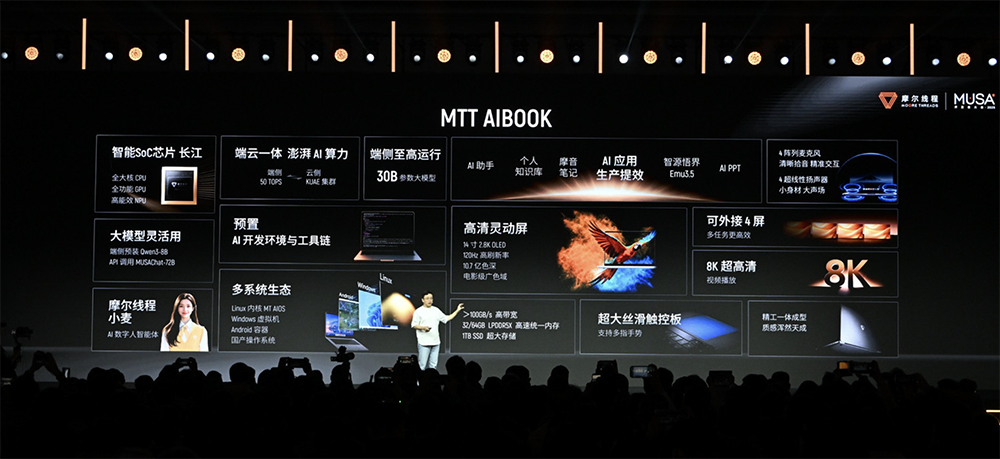
AIBOOK实现了从芯片、驱动到开发环境的全栈整合,不仅使得AI开发的“开箱即用”,更创新地打破Linux开发、Windows办公与Android应用之间场景壁垒,将强大的AI能力转化为人人可及的生产力,赋能开发者在AI时代成为“超级个体”。
它不仅是创新工具,更将成为开发者接入MUSA生态的重要入口。
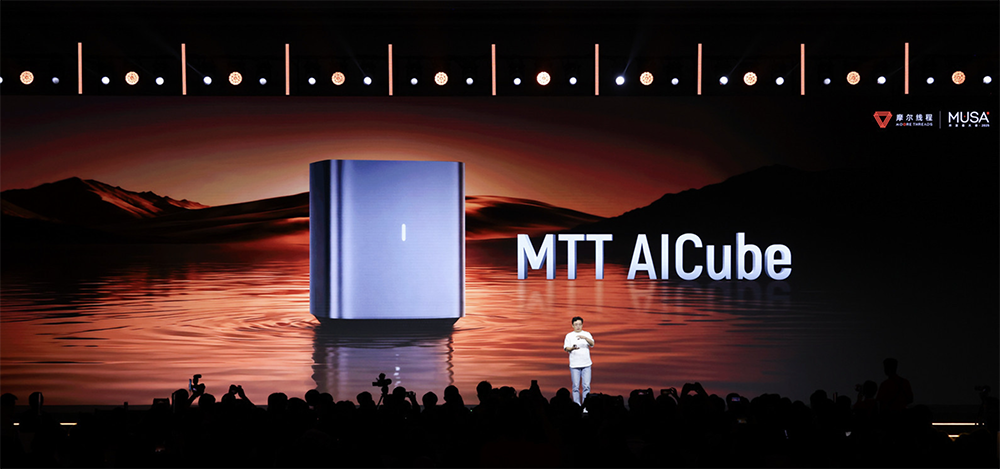
大会同期发布AI模组MTT E300,并预告了迷你型计算设备MTT AI Cube。
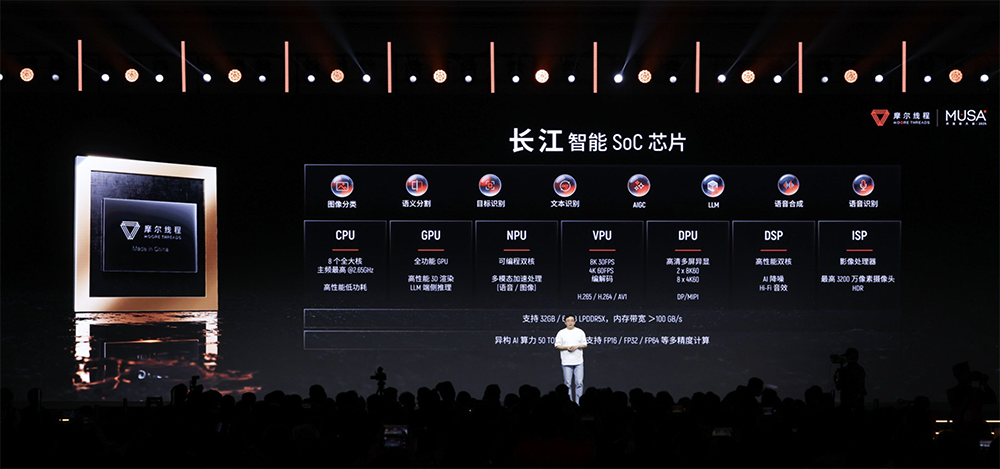
这些计算设备均搭载了自研智能SoC“长江”芯片。这款芯片集成了高性能全大核CPU、全功能GPU、可编程双核NPU、VPU、DSP、ISP,支持32GB/64GB LPDDR5X ,内存带宽超过100GB/s,异构AI算力达50TOPS,支持INT8/FP16/FP32混合精度计算。
摩尔线程还披露了图形技术路线图:率先拥抱“图形+AI”,实现硬件级光线追踪加速。
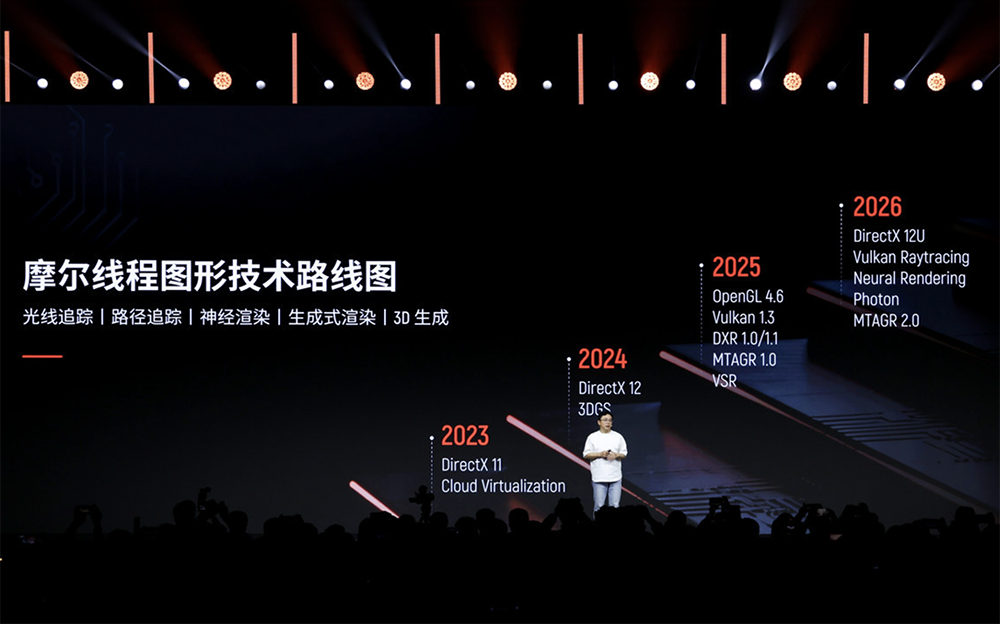
此次大会亦发布了MUSA 5.0全栈软件、MUSA图形软件栈、大模型推理套件等一系列升级,进一步降低开发门槛。
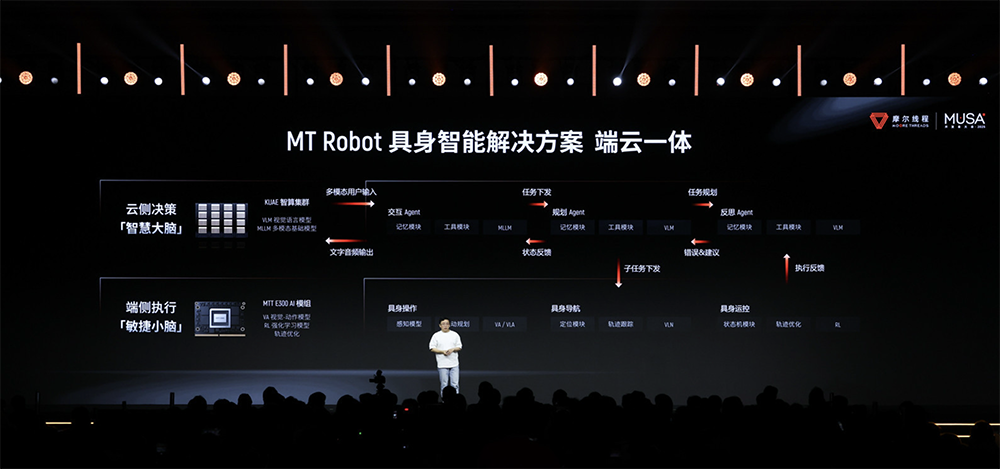
面向具身智能领域,摩尔线程发布MT Lambda具身智能仿真训练平台、夸娥智算集群“端云结合”的MT Robot具身智能解决方案,并宣布将于2026年第一季度开源关键仿真加速组件Mujoco-warp-MUSA,以开放协作助力机器人产业研发效率提升。
截至今年6月30日,摩尔线程拥有超过500个已授权专利,其中发明专利达到468个。
一、战略基石:MUSA 5.0全栈软件升级,即将推出计算光刻库
在主题演讲中,张建中强调了MUSA架构作为全功能GPU基石的先进性与技术引领性。
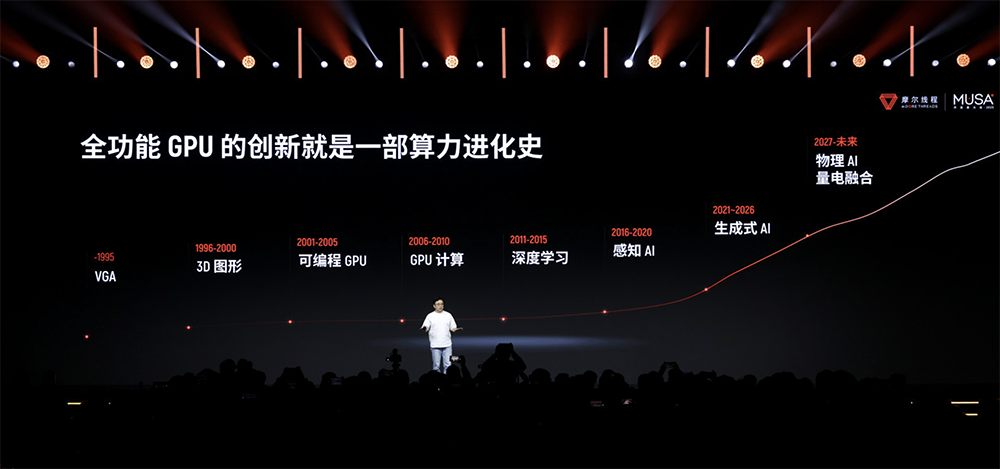
全功能GPU的创新折射出一部算力进化史。他预测2021年-2026年是生成式AI时代,2027年后是物理AI和量电融合的时代,基础设施采用全功能GPU,就可以保持科技持续领先。
摩尔线程的全功能GPU有四大核心引擎:AI计算加速引擎、图形渲染引擎、物理仿真和科学计算引擎、超高清视频编解码引擎。
这背后,是摩尔线程自主研发的元计算统一计算架构MUSA(Meta-computing Unified System Architecture),完整定义了从芯片设计到软件生态的统一技术标准。
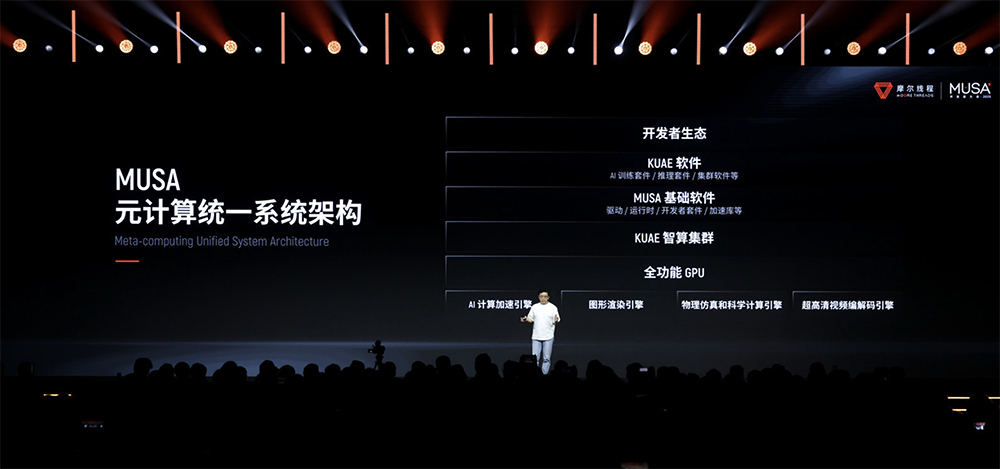
张建中宣布,MUSA 5.0全栈软件全新升级,可完整覆盖各种GPU应用场景,支持国内外主流CPU、操作系统及开发环境。
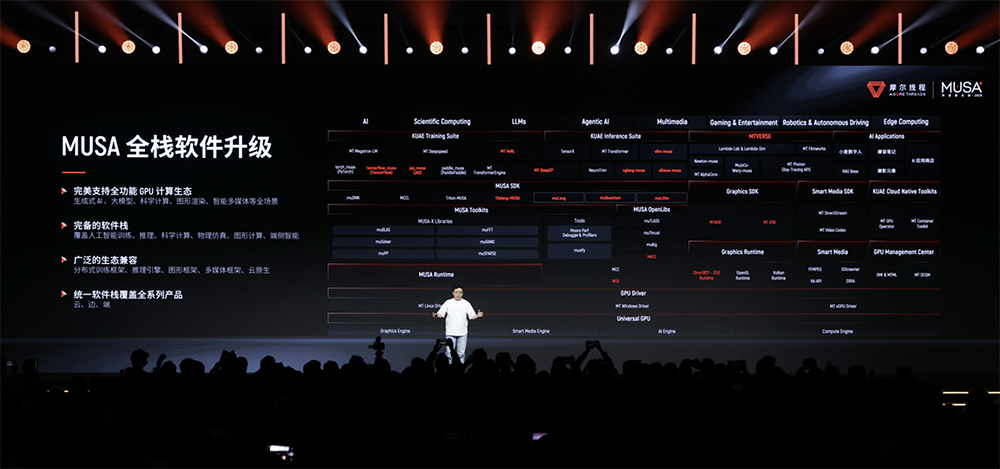
MUSA 5.0在全栈统一性、极致效能与生态开放性上取得关键突破。
(1)编程生态全面升级:既兼容CUDA C,又有原生MUSA C,深度兼容TileLang、Triton等编程语言,还原生支持智源研究院开发的FlagOS & Triton,为开发者提供灵活高效的全栈开发体验。
(2)计算效能极致优化:核心计算库muDNN实现GEMM、FlashAttention效率超98%,通信效率达97%,编译器性能提升3倍,并集成高性能算子库和开发者工具,显著加速训练与推理全流程。
(3)开源生态持续扩大:计划逐步开源计算加速库、通信库、系统管理框架等核心组件,向开发者社区开放深度优化的底层能力。
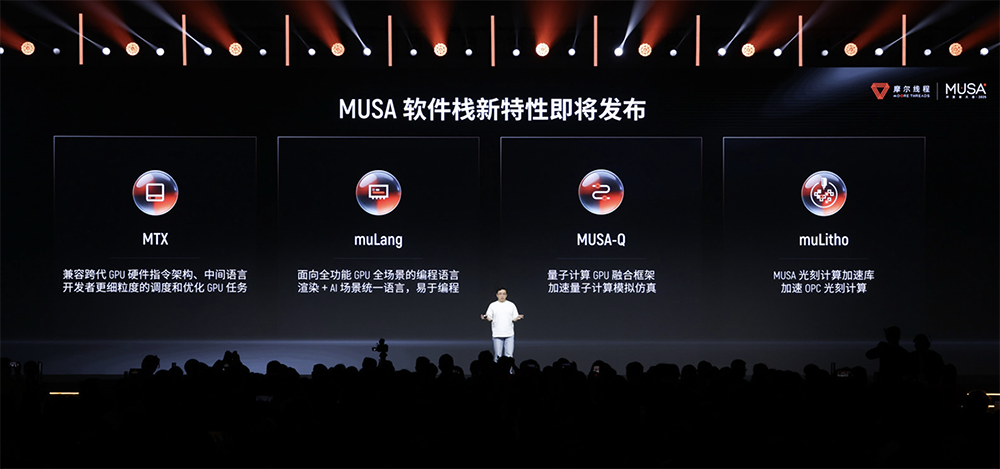
(4)即将推出四大基础库:兼容跨代GPU指令架构的中间语言MTX、面向渲染+AI融合计算的编程语言muLang、量子计算GPU融合框架MUSA-Q、加速OPC光刻计算的计算光刻库muLitho。
二、硬件核心:公布技术路线图,花港新架构首揭秘
花港架构基于全栈自主研发,采用新一代指令集,支持FP4到FP64的全精度端到端计算,算力密度提升50%,能效提升10倍,新增MTFP6/MTFP4及混合低精度支持,兼容MXFP和NVFP,内置低精度补偿技术。
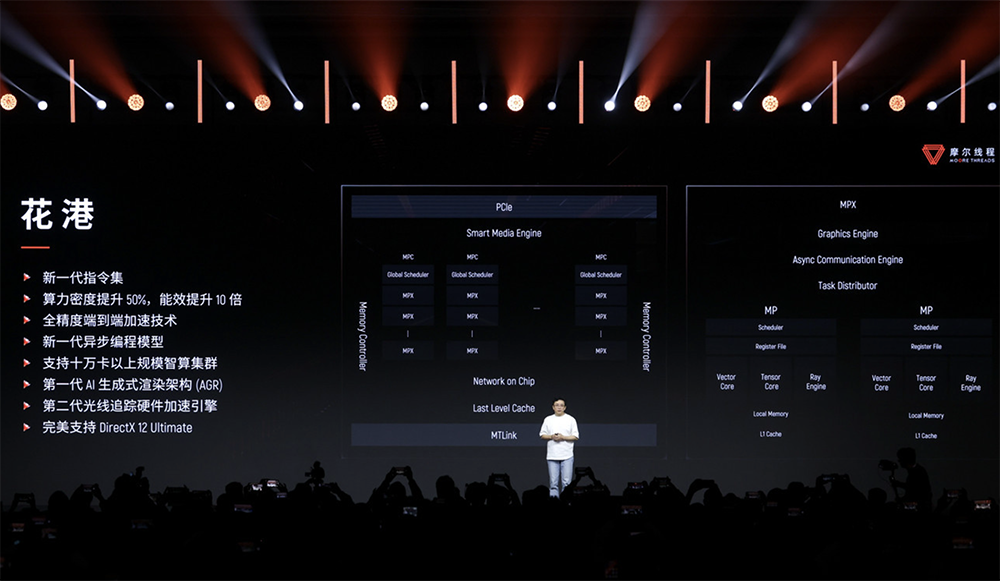
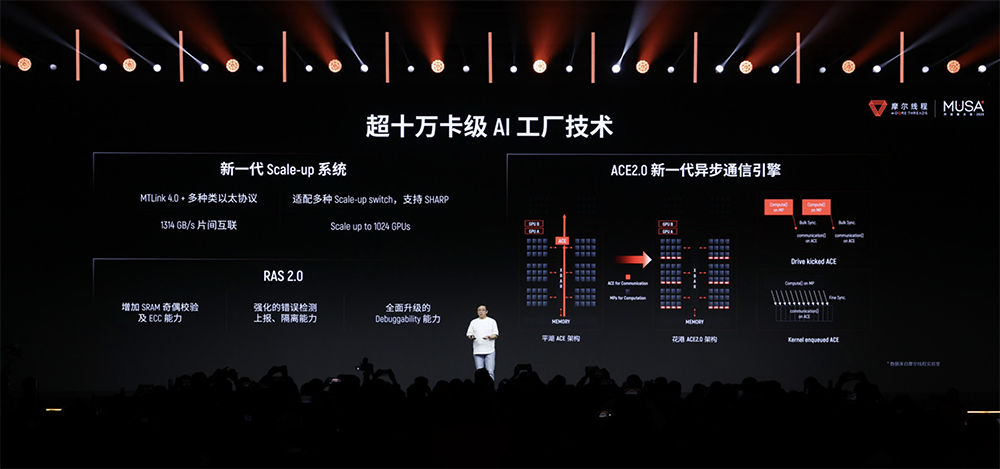
该架构集成新一代异步编程模型,优化任务调度与并行机制,高效发挥算力;通过自研MTLink高速互联技术,支持1314GB/s片间互联,支持超十万卡级智算集群扩展。
在花港ACE2.0架构中,摩尔线程在每个MP里设计了一个小ACE引擎,通过更多的通信和计算并行,使效果显著提升。
此外,花港做到了图形与AI深度融合:内置AI生成式渲染架构(AGR),增强硬件光线追踪加速引擎,完整支持DirectX 12 Ultimate。
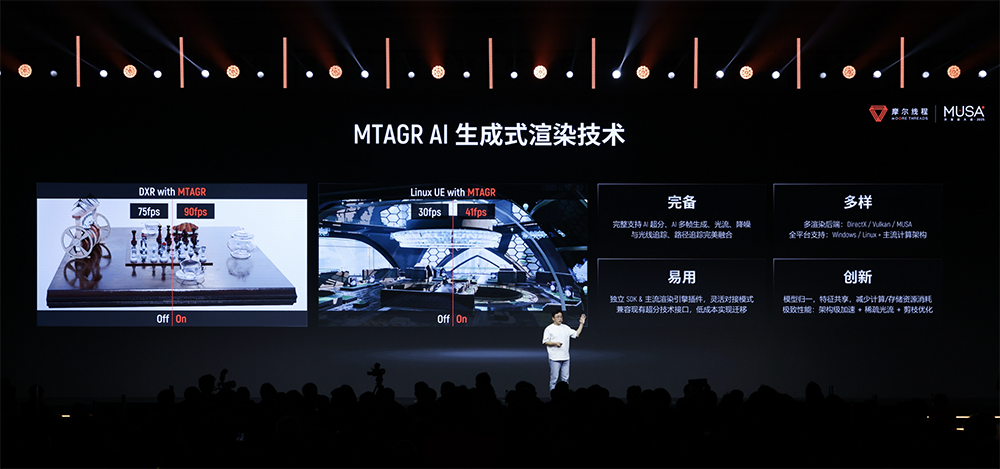
基于“花港”架构的硬件光线追踪加速引擎,可实现对DirectX Raytracing (DXR)的支持,使实时、逼真的光影效果在国产GPU上成为可能,性能比MTT S80快50倍。
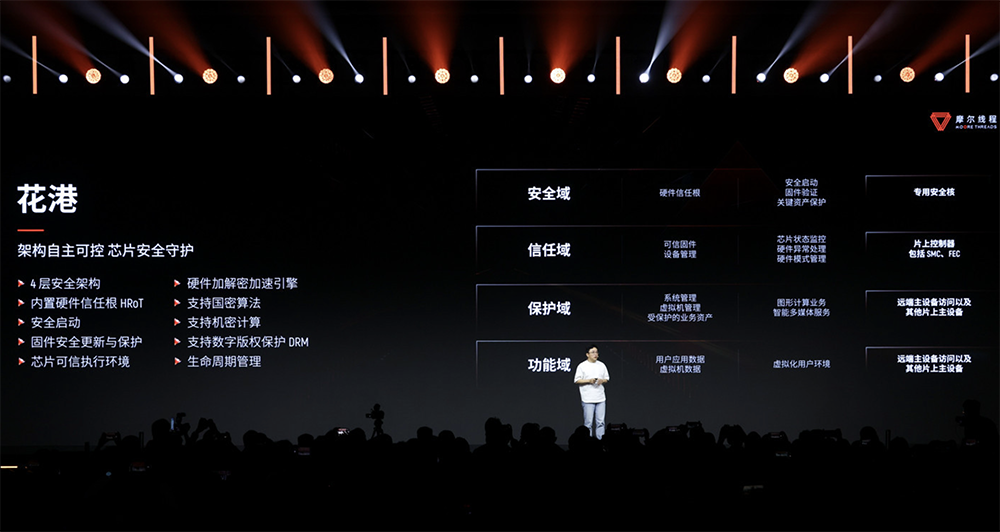
除了具备自主可控的核心能力外,花港还具有高安全性,通过4层硬件安全架构,提供从芯片到系统的可验证安全守护。
三、夸娥万卡智算集群算力达10EFLOPS,单卡刷新国产GPU推理性能纪录
会上,摩尔线程正式发布夸娥万卡智算集群。该集群具备全精度、全功能通用计算能力,在万卡规模下实现高效稳定的AI训练与推理。
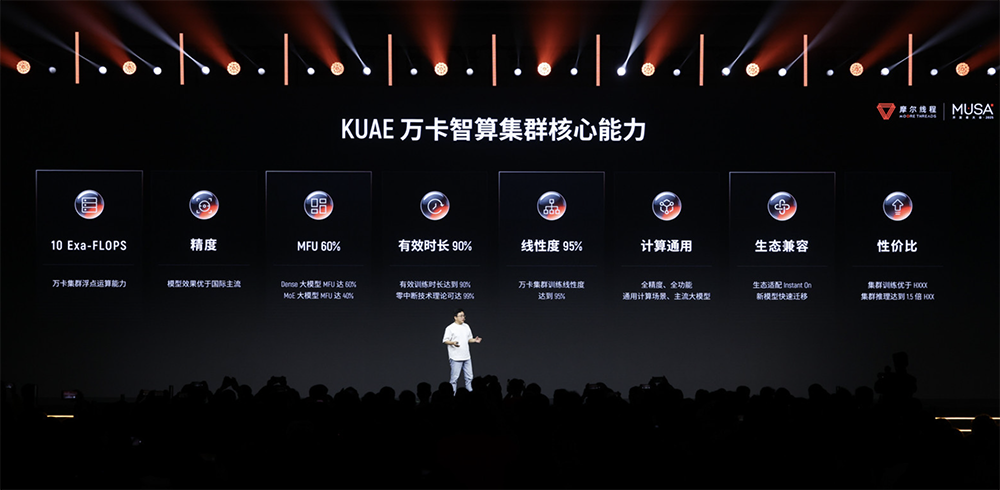
其有8大亮点:
- 浮点运算能力达到10EFLOPS;
- 在多项关键精度指标上,模型效果达到国际主流水平;
- 训练算力利用率(MFU)在Dense大模型上达60%,MOE大模型上达40%;
- 有效训练时间占比超过90%;
- 训练线性扩展效率达95%;
- 计算通用;
- 与国际主流生态高度兼容;
- 在多项指标上具备显著能效和性价比优势。
面向大模型训练,随着大模型走向万亿参数、复杂MoE架构,大模型训练集群规模迈向10万卡,训练精度从FP16走向FP8/FP4,后训练强化学习算力需求快速爆发,带来应对大规模训练、实现高性能训练、保证可靠性训练方面的挑战。
摩尔线程通过软硬协同,分层优化,系统性攻克这些挑战:GPU提供低精度FP8计算能力、ACE异步通信引擎;MUSA架构提供高性能算子与通信原语;兼容主流的AI框架;通过MT-Megatron等分布式训练工具,实现高效并行与高吞吐RL;最终由夸娥智算集群平台提供零中断容错与统一可观测。
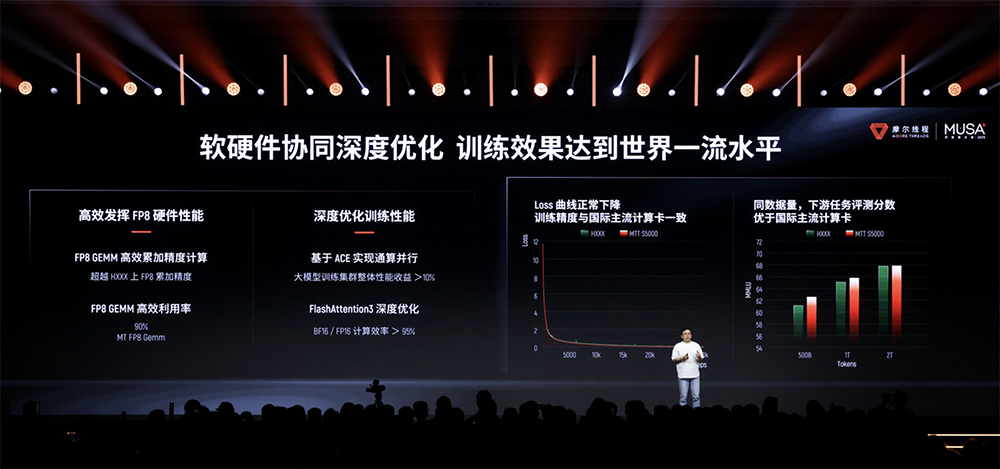
同时,通过软硬协同深度优化,摩尔线程完整复现DeepSeek V3的FP8训练,自研FP8 GEMM通过精细化优化,算力利用率高达90%;通过极致算子性能优化,Flash Attention的算力利用率超95%。在展示的案例中,MTT S5000集群实现了比国际主流计算卡更好的DeepSeek训练效果。
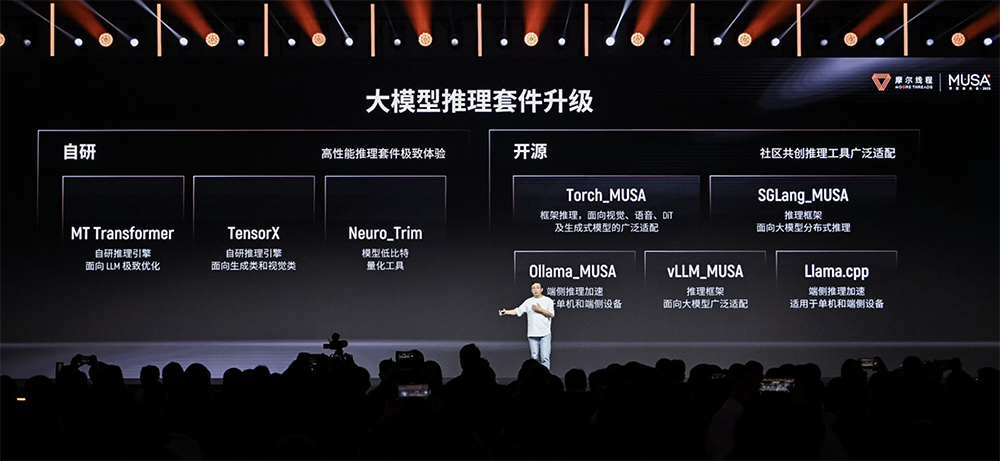
面向大模型推理,挑战在于降低成本和让服务更快。为了充分发挥硬件性能,摩尔线程发布升级的大模型推理套件,全面支持开源社区引擎。
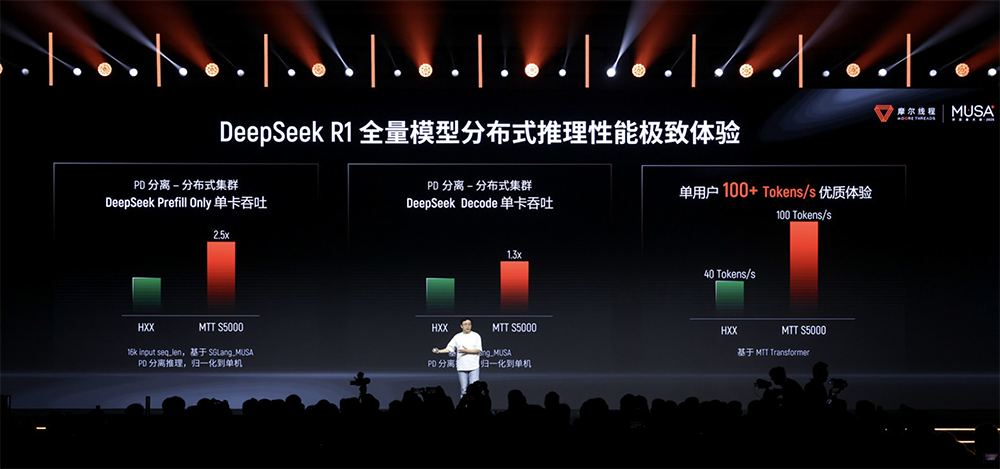
结合这些推理引擎,在DeepSeek R1 671B全量模型分布式推理场景中,MTT S5000能实现优于HXX的Prefill Only和Decode单卡吞吐,单用户每秒有超过100个token。
摩尔线程联合硅基流动,经过系统级工程优化与FP8精度加速,在DeepSeek R1 671B全量模型上实现性能突破:MTT S5000单卡Prefill吞吐突破4000 tokens/s、Decode吞吐突破1000 tokens/s。这一结果刷新了国产GPU的推理性能纪录。
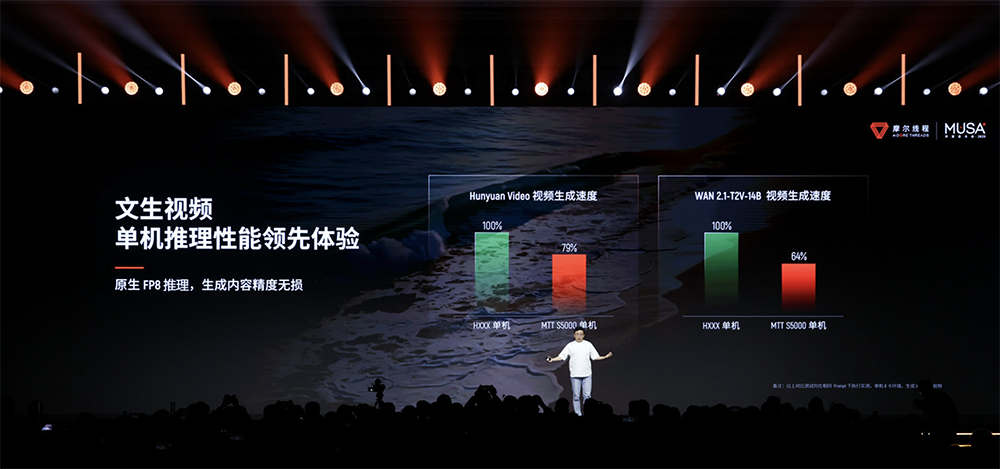
在运行混元、万相视频生成模型时,MTT S5000单机推理速度比HXXX更快。
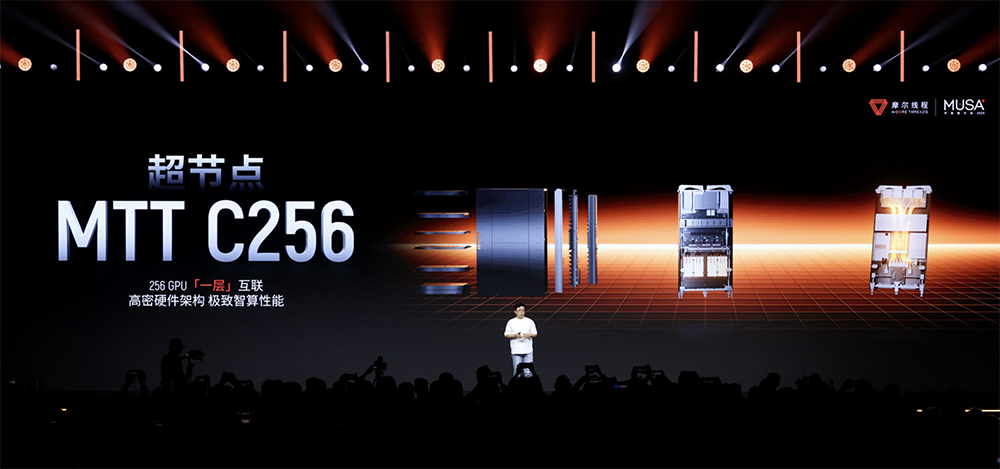
面向未来,摩尔线程发布了MTT C256超节点的架构规划。该产品为下一代超大规模智算中心构建,采用计算与交换一体化的高密设计,以1层scale up网络实现2柜256GPU全互联,规避2层以上网络带来的带宽损失和额外延迟,旨在系统性提升万卡集群的训练效能与推理能力,兼顾超高密度与极致能效。
四、培养百万MUSA开发者,AI算力本提供“开箱即用”一站式开发
GPU计算生态由上层算法库,中层接口、驱动、编译器和底层硬件架构三大部分基本构成,计算生态的丰富性是GPU的核心竞争力之一。
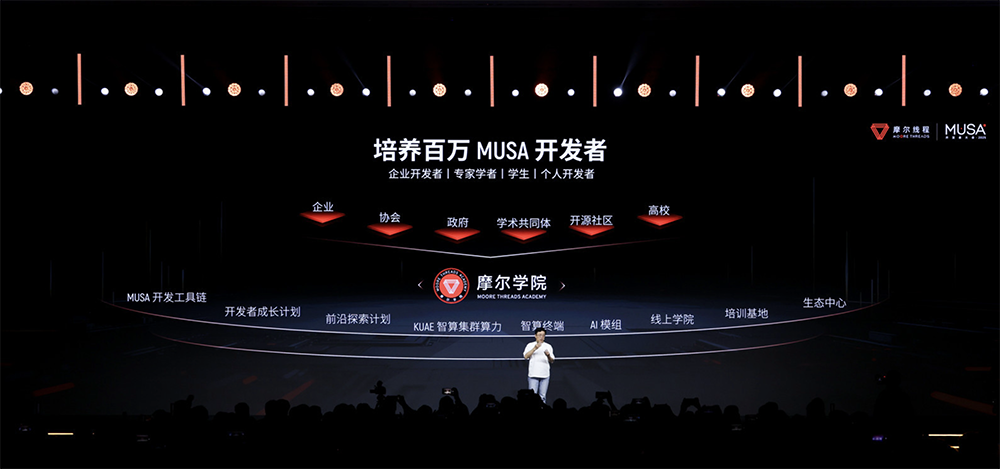
摩尔线程构建了从硬件工具、算力支撑到人才培养的赋能体系。
1、深化人才培养,建设MUSA生态枢纽
以摩尔学院为平台,摩尔线程已构建起产教融合的开发者成长体系,该平台汇聚近20万名开发者与学习者,并通过“国产计算生态与AI教育共建行动”将前沿技术与产业实践带入全国200多所高校,吸引超10万名学子参与。
本次大会宣布建设MUSA生态中心,同时发布MUSA开发者计划,旨在为从AI学习探索到科研创新的各阶段创新者,提供算力支持与技术赋能。
2、发布AI算力本,提供“开箱即用”的开发体验
作为连接开发者与MUSA生态的核心入口,MTT AIBOOK搭载自研“长江”智能SoC,提供高达50TOPS的端侧AI算力、32GB/64GB高速内存、1TB SSD超大存储。
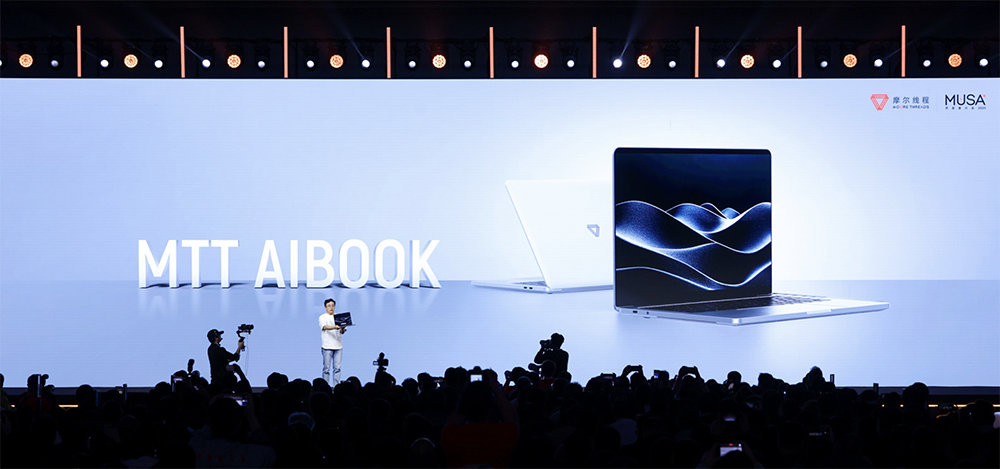
这是一款专为AI学习与开发者打造的个人智算平台,从芯片、驱动到开发环境全栈整合,实现了专业AI开发的“开箱即用”,可随心切换Linux开发、Windows办公、Android应用,亦支持国产操作系统,以便开发者快速搭建智能体。

在展区,智东西看到MTT AIBOOK里已经安装了百度网盘、飞书、腾讯会议、腾讯文档、QQ等常见应用。
大会同时预告了基于长江芯片打造的迷你型计算设备MTT AI Cube,进一步丰富端侧计算产品形态。
张建中谈道,生态体系是GPU行业的核心护城河与价值所在,依托MUSA架构的优势,摩尔线程持续加大研发投入,致力于攻克从硬件到软件的核心技术挑战,以开放创新不断深化与生态伙伴的协同,共同构建自立自强的国产计算产业生态。
结语:国产智能计算生态持续演进
随着技术及生态走向成熟,国产GPU落地渐呈燎原之势。
在这场聚焦全功能GPU的开发者盛会上,中国工程院院士、清华大学计算机系教授郑纬民发表主题演讲,提到发展“主权AI”是提升未来国家竞争力的关键,其核心在于实现“算力自主、算法自强、生态自立”的完整体系。
据郑纬民院士分享,国产计算显卡与国外主流产品的性能差距正在持续缩小,虽然构建国产万卡乃至十万卡级别的超大规模智算系统存在难度,但这是必须完成的产业基础设施任务。开发者是生态建设的关键,国产芯片平台必须构建起友好、易用的开发环境,以有效服务开发者社群。
MUSA开发者大会2025展示了摩尔线程以自主统一架构MUSA为根基、贯穿“芯-边-端-云”的完整技术栈,落地范畴覆盖从超大规模基础设施到开发者终端。
面向更广阔的未来计算场景,摩尔线程已展开前瞻性布局。MUSA生态已与合作伙伴在具身智能、科学智能(AI for Science)、量子科技、AI for 6G等前沿交叉领域展开探索工作,持续拓展全功能GPU作为通用算力底座的技术边界与应用价值。
国产GPU还在闯关,但这条路,已经肉眼可见地越来越有希望。


